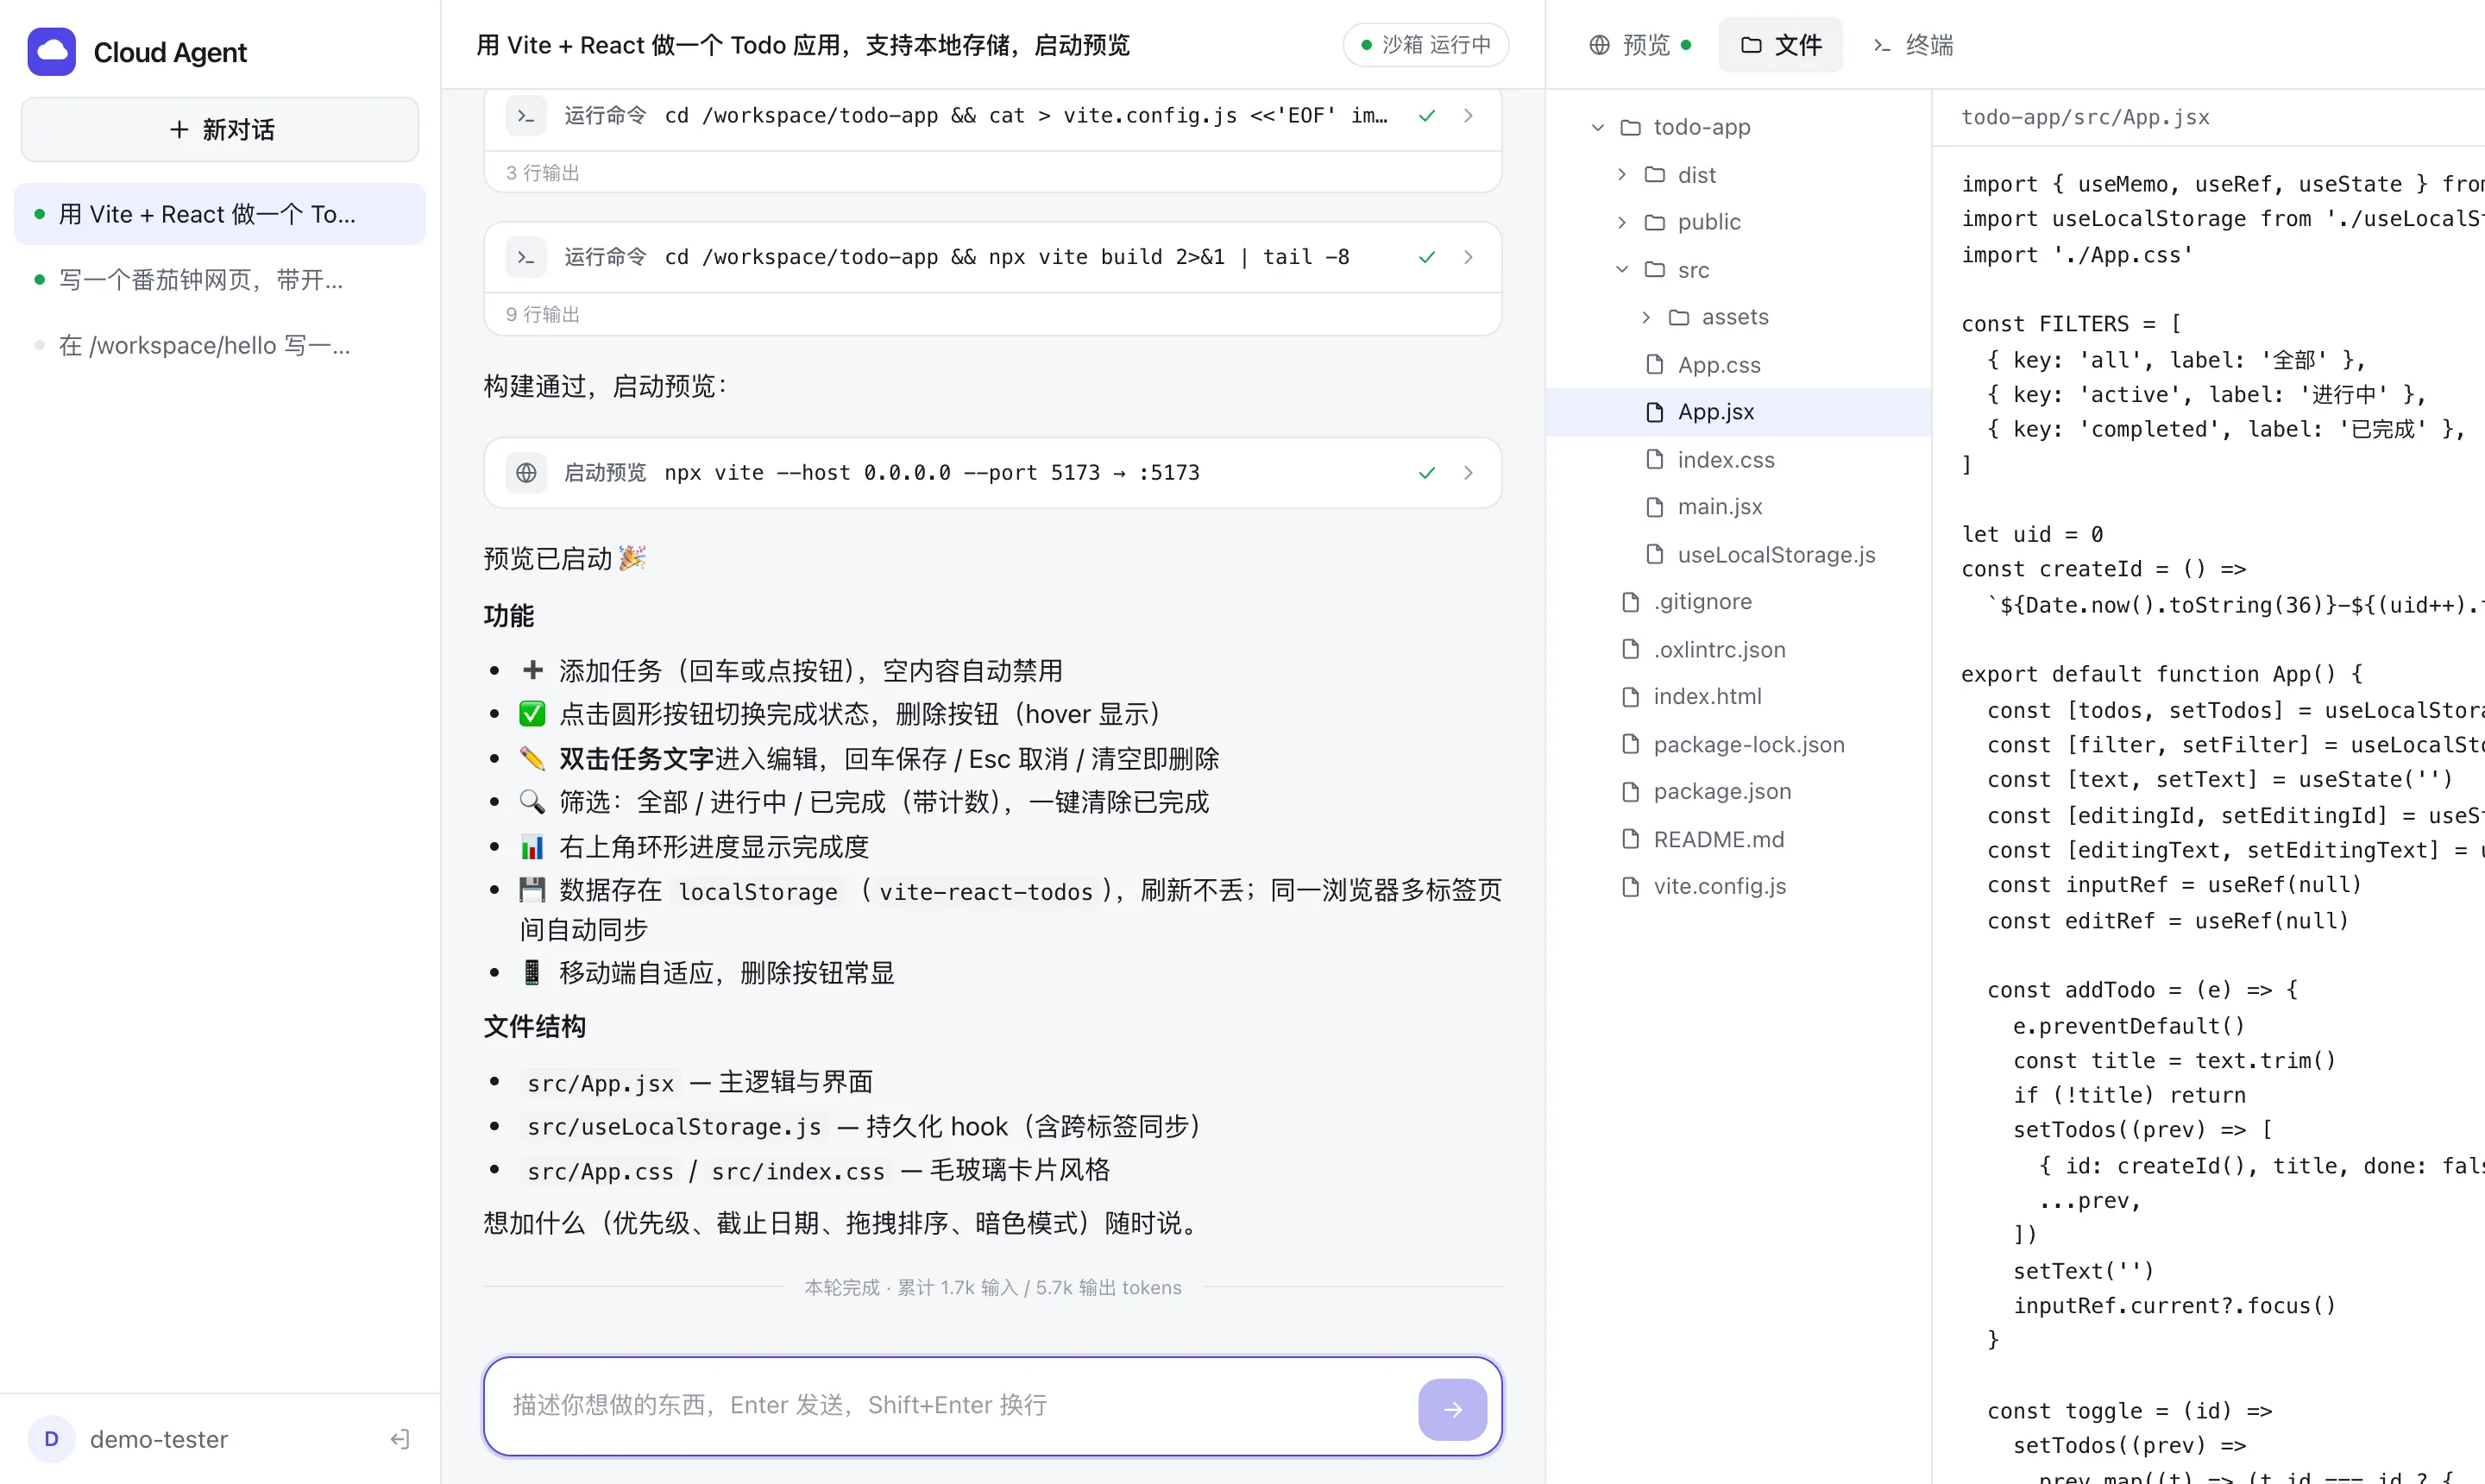
用户在网页上描述需求,agent 在云端写代码、装依赖、起服务,网页上实时看到过程并直接预览结果。这篇讲它的原理,以及实现时的选型。
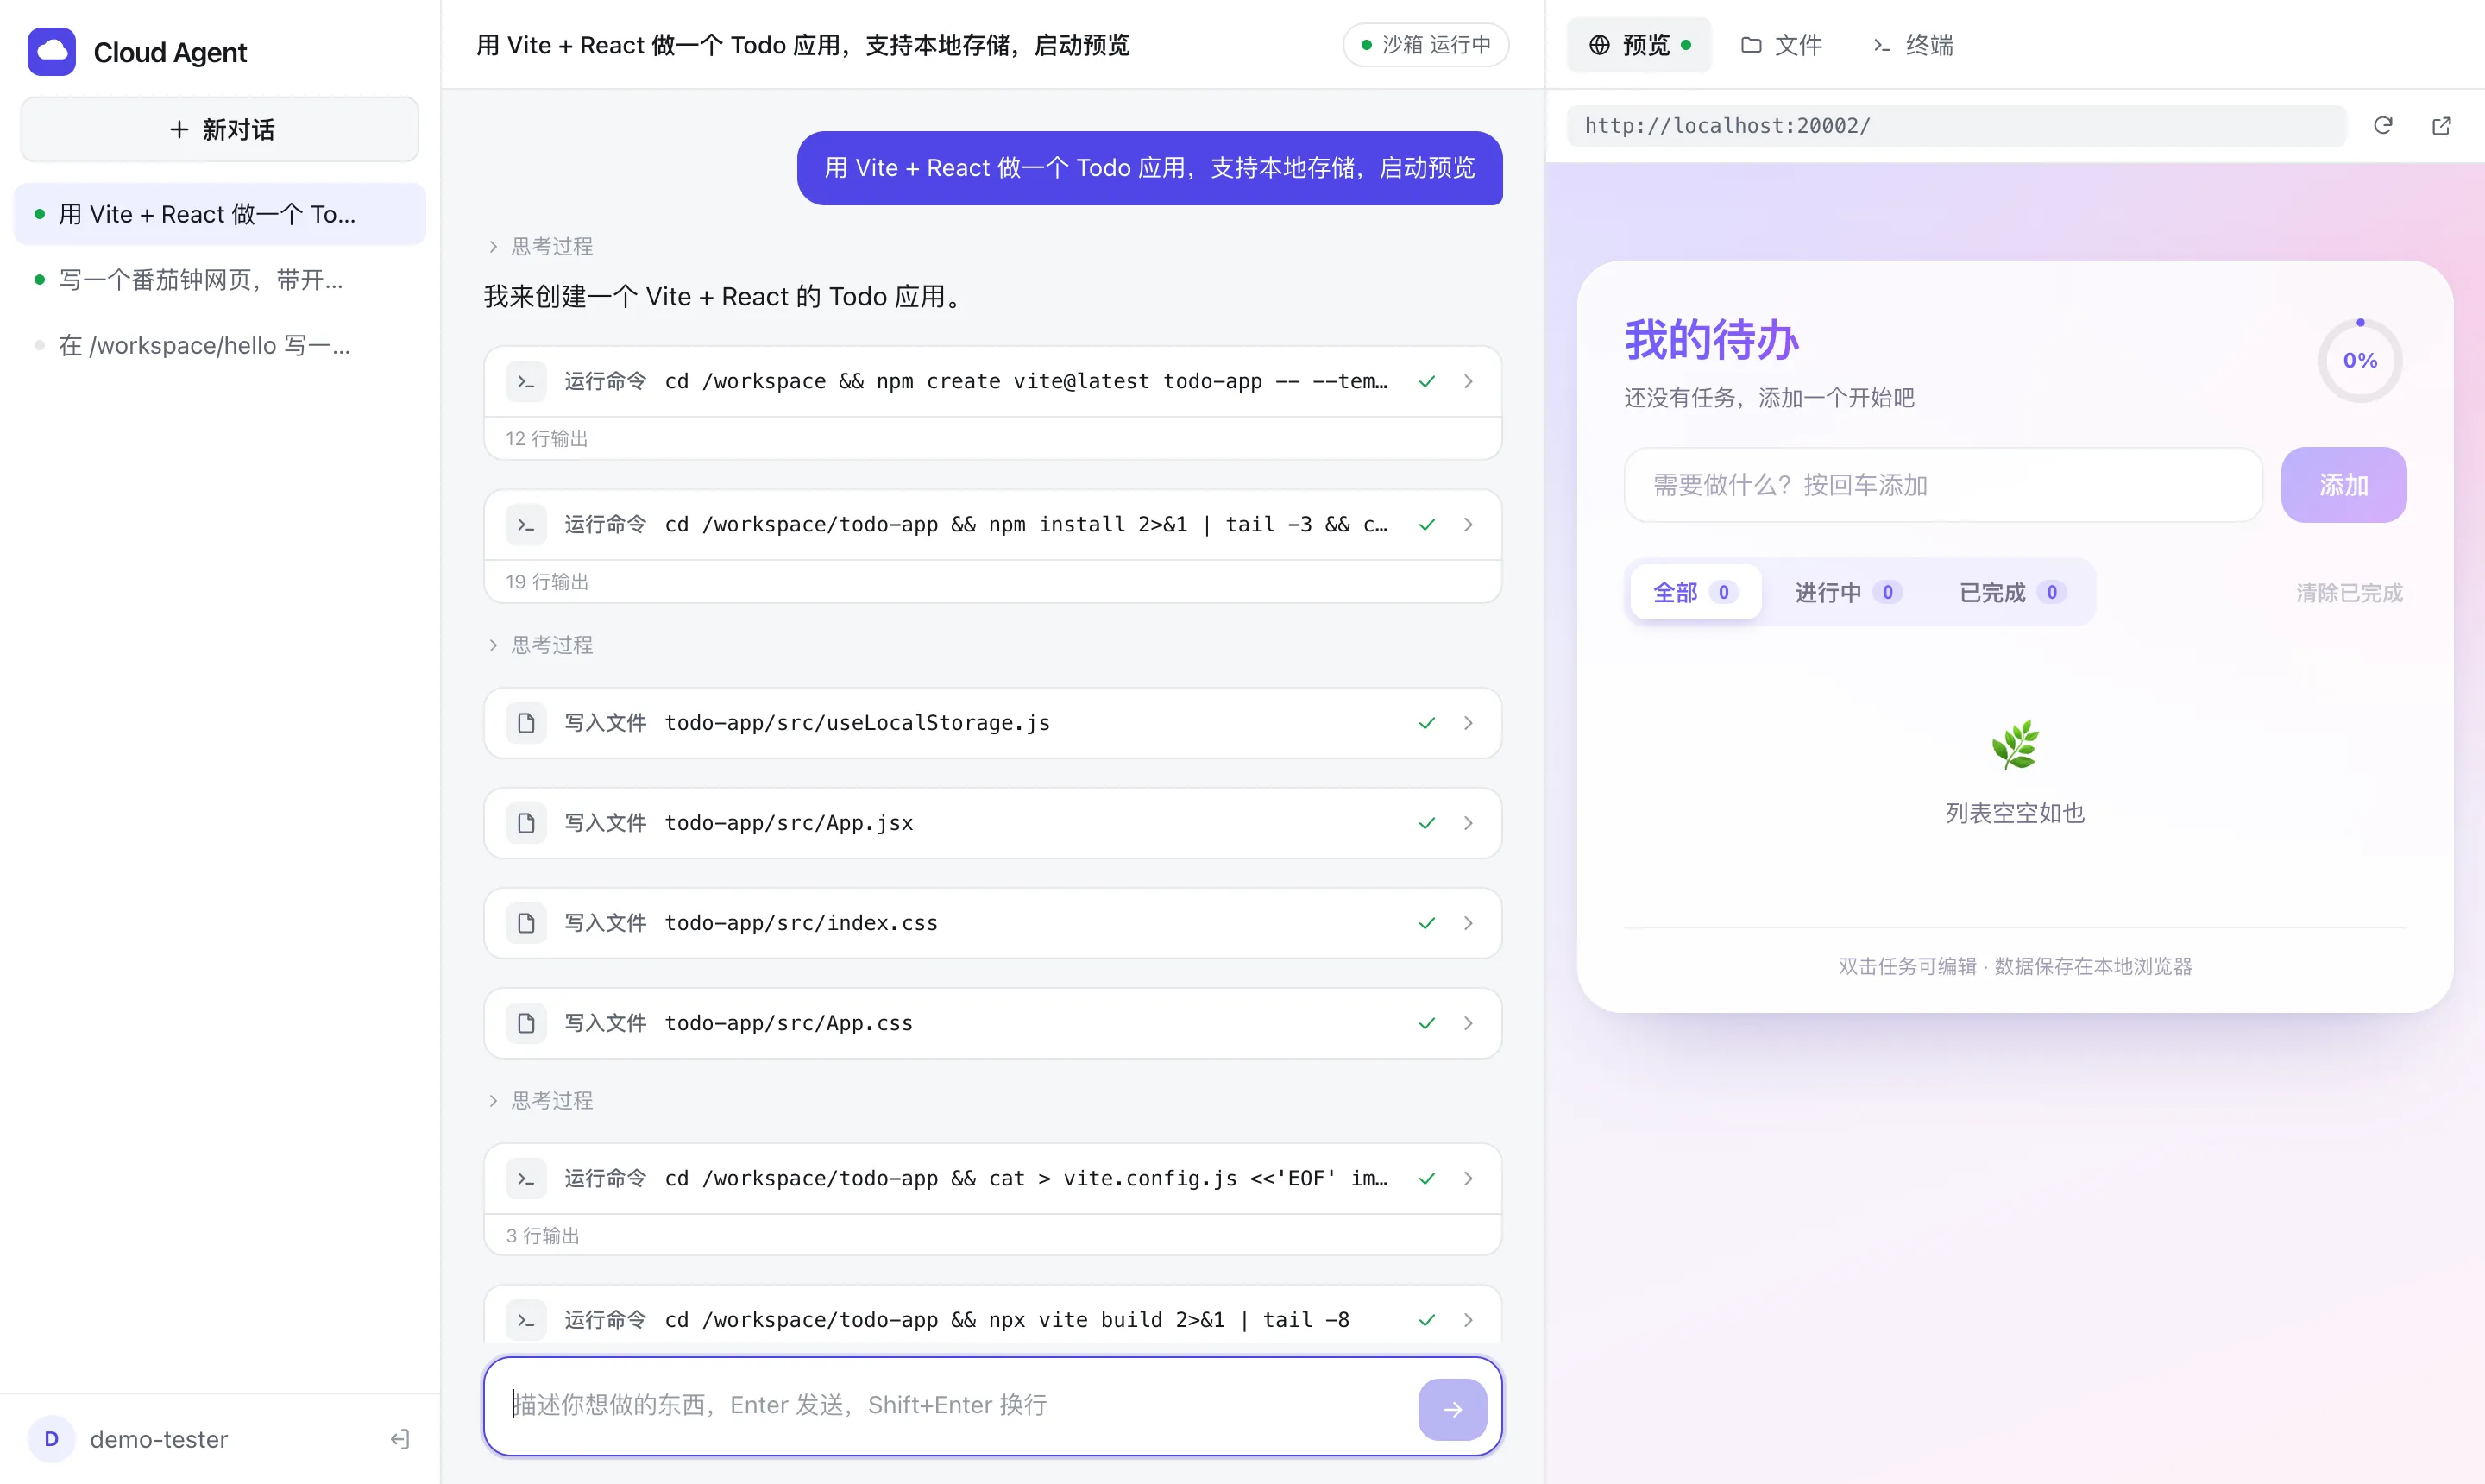
输入「用 Vite + React 做一个 Todo 应用」:agent 建项目、装依赖、写代码、构建,最后启动预览,右侧直接可用。
原理
agent 是一个循环
写文件 · 跑命令 · 起服务
「agent 跑在云端」,指的就是这个循环和工具的执行都发生在服务端。
工具要有地方执行:沙箱
工具要写文件、跑命令,就需要一台机器。但要跑的是模型生成的代码,加上它装进来的第三方依赖,都不可信;多个用户之间还要互相隔离。所以每个对话分配一台独立的沙箱作为工作空间。
agent 本身留在后端,只把工具调用转发进沙箱:
+ 不可信代码和依赖
整体架构
预览请求
前端怎么同步:带编号的事件流
agent 的每个动作都变成一条事件,按顺序编号后推给浏览器,前端按顺序「播放」出来:
用 SSE 而不是 WebSocket:数据基本是单向的(服务端推、浏览器收),用户发消息、点中断用普通 HTTP 请求就够了;SSE 自带断线重连和 Last-Event-ID 续传。
怎么持久化
用来回放对话过程
服务重启后 agent 记得做过什么
唤醒后原样恢复
前两类存在数据库里,所以服务端的进程内存里只放正在跑的东西,随时可以丢掉,下次用到时再从库里重建。
实现
技术栈:React + Node(Hono)+ pi + CubeSandbox + DeepSeek + Postgres(Drizzle)。
Agent:pi
agent 循环本身很简单,难的是边角:流式输出、中断、运行中插话、上下文压缩。选 pi 这个轻量的开源 agent 内核,有两个原因:
- 模型无关:走 OpenAI 兼容接口,换模型只改配置
- 工具的底层可以替换:这是关键。pi 内置的读写文件、跑命令等工具,都把底层 I/O 抽成了
operations接口
相比之下,大框架抽象太多,这个场景用不上;厂商的 agent SDK 一般围绕自家模型设计,内置工具默认操作本机。
沙箱:CubeSandbox
第一步是定隔离级别。常见的有三种,区别在于沙箱里的程序和宿主机内核之间隔了什么:
不需要 KVM,但兼容性和 I/O 有损耗
- 容器:程序直接向宿主内核发系统调用,内核一旦有漏洞就能逃逸。跑不可信代码不够安全,排除
- gVisor:在中间加了一层用户态内核(Sentry),截住程序的系统调用自己处理,只把少量调用转给宿主内核。好处是不需要硬件虚拟化,普通云主机就能跑。代价是 Linux 的系统调用要重新实现一遍,并不完整,而且系统调用多的场景损耗明显
- MicroVM:每个沙箱跑一个真正的 Linux 内核,靠硬件虚拟化隔离。兼容性和普通 Linux 完全一样
coding agent 的典型负载是 npm install、编译、起 dev server,文件 I/O 和系统调用都很密集,而且要跑的软件五花八门。综合考虑,选 MicroVM:兼容性最好,隔离最彻底。代价是机器必须支持 KVM。
第二步是选具体方案:
| E2B(托管) | 自建 Firecracker | CubeSandbox | |
|---|---|---|---|
| 部署 | 无需部署 | 网络、镜像、调度全自己做 | 一键安装 |
| 数据位置 | 第三方 | 自己的机器 | 自己的机器 |
| 休眠 / 唤醒 | 有 | 自己做 | 有 |
| SDK | E2B SDK | 自己写 | 兼容 E2B SDK |
选 CubeSandbox(腾讯云开源):能自己部署,自带休眠唤醒,而且兼容 E2B 的 SDK。代码只依赖 e2b 这个库,以后想换成 E2B 托管,改一个地址就行。
实测:新建沙箱 0.5~1.2 秒,唤醒约 1.6 秒,每台实际占内存 100~700 MB。代价是需要 x86 Linux + KVM,官方建议 8G 内存起步。
预览
agent 调用自定义的 preview 工具,在沙箱里后台启动服务(比如 vite --host 0.0.0.0),然后把预览地址交给前端,用 iframe 打开。沙箱的端口浏览器访问不到,所以要经过后端代理转发。问题是,转发到哪个地址上:
→ 打到主站,404
fetch("/api/...") 读走用户数据
有域名就用子域名,只需开一个端口;没有域名时给每个预览分配一个独立端口。
除了预览,右侧还可以直接浏览沙箱里的文件。和预览不同,文件内容由后端从沙箱读出来,以纯文本的形式返回给前端,不会在浏览器里执行,所以走主站的接口就行: